La mayoría de nosotros hemos visto la televisión con el sonido apagado en un momento u otro. Si bien, por lo general, es posible seguir la historia al menos hasta cierto punto, la ausencia de una pista de audio tiende a limitar nuestra capacidad para apreciar completamente lo que está sucediendo.
Del mismo modo, es fácil pasar por alto mucha información simplemente escuchando los sonidos que provienen de otra habitación. La multimodalidad de combinar imagen, sonido y otros detalles mejora enormemente nuestra comprensión de lo que sucede, ya sea en la televisión o en el mundo real.
Lo mismo parece ser cierto para la inteligencia artificial. Un nuevo modelo de respuesta a preguntas llamado MERLOT RESERVE permite predicciones listas para usar, lo que revela una sólida comprensión de sentido común multimodal. Fue desarrollado recientemente por un equipo del Instituto Allen de Inteligencia Artificial (AI2), la Universidad de Washington y la Universidad de Edimburgo.
Como parte de una nueva generación de aplicaciones de inteligencia artificial que permiten la búsqueda semántica, el análisis y la respuesta a preguntas (QA), el sistema se entrenó haciéndolo «ver» 20 millones de videos de YouTube. Las capacidades demostradas ya están siendo comercializadas por nuevas empresas como Twelve Labs y Clipr.
MERLOT RESERVE (RESERVA para abreviar), significa Representación de eventos multimodales Aprendizaje a lo largo del tiempo, con supervisión de eventos de reingreso, y se basa en el modelo MERLOT anterior del equipo. Fue entrenado previamente en millones de videos, aprendiendo de la entrada combinada de sus imágenes, audio y transcripciones. Los cuadros individuales permiten que el sistema aprenda espacialmente, mientras que el entrenamiento a nivel de video le brinda información temporal, entrenándolo sobre las relaciones entre elementos que cambian con el tiempo.
“La forma en que la IA procesa las cosas va a ser diferente de la forma en que lo hacen los humanos”, dijo el científico informático y líder del proyecto Rowan Zellers. “Pero hay algunos principios generales que serán difíciles de evitar si queremos construir sistemas de IA que sean robustos. Creo que la multimodalidad definitivamente está en ese segmento”.
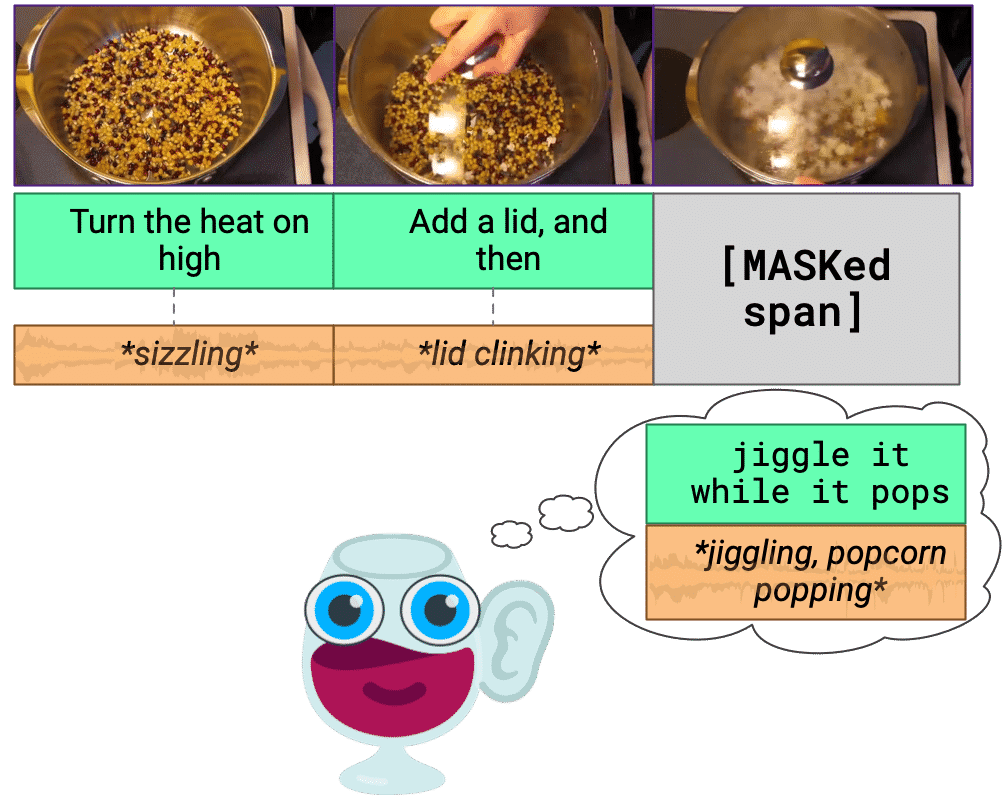
Debido a que vivimos en un mundo dinámico, el equipo quería explorar la construcción de máquinas que aprendan juntas de la visión, el lenguaje y el sonido. En uno de los ejemplos del periódico, se ve a alguien cocinando palomitas de maíz. Solo a partir de las imágenes y el diálogo, podemos imaginar los sonidos que podrían acompañarlos. El sonido de los granos crudos moviéndose sobre la superficie metálica de una olla podría eventualmente cambiar a «pops» enérgicos cuando estallan en palomitas de maíz blancas y esponjosas.
Tal predicción se conoce como «aprendizaje del reingreso», donde las correlaciones bloqueadas en el tiempo permiten que una modalidad eduque a otras. Algunos psicólogos del desarrollo han planteado la hipótesis de que así es como aprendemos el conocimiento visual y del mundo, a menudo sin un maestro. También es la base del nombre de RESERVA: Supervisión de Eventos Reentrantes.
El modelo se entrena en segmentos de video de 40 segundos de duración, donde los fragmentos de texto y audio se «enmascaran» del sistema. RESERVE luego aprende seleccionando el fragmento enmascarado correcto de cuatro opciones de opción múltiple. Esto es seguido con la selección de cuatro posibles razones para justificar su respuesta.
Este enfoque no solo permitió a RESERVE lograr resultados de última generación a partir de su entrenamiento semisupervisado, sino también hacer fuertes predicciones de tiro cero. En este caso, un ejemplo de predicción de tiro cero podría ser una pregunta como «¿Qué está haciendo la persona?» Esto se puede reescribir manualmente o automáticamente como una declaración como «La persona es [MASK].” Luego, el modelo hace una predicción de opción múltiple sobre un conjunto de opciones proporcionadas como «cocinar palomitas de maíz» o «comer palomitas de maíz».
RESERVE se ajustó en varios conjuntos de datos a gran escala utilizados para la comprensión visual a nivel cognitivo: VCR, TVQA y Kinetics-600. RESERVE exhibió un rendimiento de vanguardia, superando el trabajo anterior en un 5 %, 7 % y 1,5 %, respectivamente. Al incorporar audio, el modelo logra una precisión del 91,1 % en Kinetics-600.
VCR (razonamiento visual de sentido común) es un conjunto de datos a gran escala sin audio que se utiliza para la comprensión visual a nivel de cognición. TVQA es un conjunto de datos de control de calidad de video a gran escala basado en seis programas de televisión populares (Amigos, La teoría del Big Bang, Cómo conocí a vuestra madre, House MD, Anatomía de Grey, y Castillo). Finalmente, Kinetics-600 es una colección de 650.000 videoclips que cubren cientos de clases de acción humana.
Según el documento del estudio, que se presentará en la Conferencia internacional IEEE/CVF sobre visión por computadora y reconocimiento de patrones en junio, RESERVE muestra mejoras significativas en el rendimiento con respecto a los modelos de la competencia. Por ejemplo, requiere una quinta parte de las operaciones de punto flotante utilizadas por el modelo multimodal de VisualBERT.
El equipo del proyecto anticipa que los modelos preentrenados en video algún día podrían ayudar a los usuarios sordos o con baja visión o usarse para extraer información sobre las tendencias de visualización de videos. Sin embargo, también reconocen que los conjuntos de datos utilizados para entrenar a RESERVE introducen sesgos inevitables que deben abordarse.
Más allá de las palabras que se pronuncian, el audio puede proporcionar mucha información contextual adicional. Esto no debería ser una sorpresa para nosotros, según nuestras propias experiencias, pero es fascinante que el rendimiento de la IA también pueda mejorar significativamente. Eso puede deberse a que al sincronizar la información adicional, se pueden realizar nuevas correlaciones estadísticas.
“El audio es muchas cosas. No es solo la voz, sino también los efectos de sonido, y escuchar esos efectos de sonido mejora tu comprensión del mundo”, observó Zellers.
“Otra cosa es el tono de voz, la dinámica de la comunicación humana. Si solo miras las palabras, sin el contexto del audio, te pierdes mucho. Pero si alguien dice esa palabra con una emoción específica, entonces el modelo puede hacerlo mucho mejor. Y, de hecho, descubrimos que sí”.
MERLOT y RESERVE son parte del equipo Mosaic de AI2 que se enfoca en desarrollar sistemas que puedan medir y desarrollar el sentido común de las máquinas. El sentido común de las máquinas ha sido un área de interés en el campo de la inteligencia artificial durante décadas. Ser capaz de factorizar y anticipar las relaciones del mundo real entre diferentes objetos y procesos haría que nuestras herramientas de IA fueran mucho más útiles para nosotros.
Sin embargo, no es suficiente simplemente cargar un montón de hechos y reglas sobre cómo funciona el mundo en un sistema y esperar que funcione. El mundo es simplemente demasiado complejo para hacer esto. Nosotros, por otro lado, aprendemos al interactuar con nuestro entorno a través de nuestros diversos sentidos desde el momento en que nacemos. Construimos gradualmente una comprensión de lo que sucede en el mundo y por qué. Algunos proyectos de sentido común de máquinas utilizan un enfoque similar. Para MERLOT y RESERVA, la incorporación de modalidades adicionales aporta información extra al igual que lo hacen nuestros sentidos.
“Creo que a mediano y largo plazo, lo que realmente me emociona es la IA que conversa con nosotros en múltiples modalidades, como audio y gestos, para que pueda establecer conexiones sobre las cosas que estamos haciendo”, observó Zellers. Los autores del documento del proyecto, «MERLOT RESERVE: Neural Script Knowledge through Vision and Language and Sound» son Rowan Zellers, Jiasen Lu, Ximing Lu, Youngjae Yu, Yanpeng Zhao, Mohammadreza Salehi, Aditya Kusupati, Jack Hessel, Ali Farhadi y Yejin Choi. Puede encontrar una demostración de RESERVE en AI2.
Deja una respuesta